你需要重整的,不是一段 Prompt,而是整個人機協作架構。
否則,無論你換 Hermes、換模型、加裝 Memory、建立知識庫,最後通常只會得到三件事:更多 Token 消耗、更長的來回溝通,以及一個看似功能很多、實際上越來越難駕馭的 AI 系統。
很多人以為自己「不太會用 AI」,其實不完全是。
真正的問題是:我們正用一種極度原始的方式,管理一個本來應該能長期協作的系統。
你不是不會用 Hermes,而是正在使用一個會遺忘、會失焦、還很燒錢的系統
你可能也有這樣的經驗。
一開始,你只是想請 Hermes 幫忙寫一段程式、整理研究資料、建立一個自動化流程,或分析一份市場數據。你花了不少時間說明背景、目標、資料來源、工具限制、檔案位置與輸出格式。
模型看起來理解了。
但對話拉長後,Token 開始像漏水一樣失控。
它重複問你已經回答過的問題;忘記前面才確認的規則;把不重要的細節放大,卻漏掉真正不能犯錯的條件。你原本只想完成一件工作,最後卻花大量時間在補充背景、糾正方向、重述需求。
更麻煩的是,只要換一個新對話,幾乎一切又得重新開始。
你得再解釋一次自己在做什麼、資料放在哪裡、程式怎麼執行、哪些規則不能碰、報告的格式是什麼。即使你明明已經做過十次,AI 仍像第一次認識你。
於是你開始做「正確的事」:
你建立知識庫、寫 Memory、整理筆記、保存重要 Prompt、把 SOP 放進 Markdown,甚至替不同任務建立不同的文件資料夾。
理論上,這些內容應該讓 Agent 越用越懂你。
但實際上,它常常沒有讀。
或是讀了,卻沒有照做。
又或者,它只抓到一段看似相關的舊資料,忽略真正重要的限制。你明明把規則寫進 Memory,模型卻像沒看見;你明明把流程放進知識庫,它卻臨時發明另一套做法。
最後,你反而變成整個系統的人工記憶體。
你得自己記得哪份筆記是最新版、哪個 SOP 已經修正、哪些資料可能過期、哪一段 Prompt 曾經有效。每次交辦任務前,還要手動搜尋、複製、貼上,再祈禱模型這次不要漏看。
時間一長,知識庫通常不會自動變得更有價值,反而更容易變亂。
同一個問題可能有三個版本的答案;舊規則和新規則混在一起;過去修正過的錯誤被重新引用;不同對話留下的結論互相矛盾。這時候,即使 Agent 找到一份答案,你也很難確定:它到底是不是現在仍然有效的答案。
更諷刺的是,大家都說 AI 會自我學習、自我進化。
但大多數人的 Agent 並沒有越用越聰明。
它只是累積了更多對話紀錄、塞進更多 Memory、存下更多沒有整理的筆記。它依然會重複犯同樣的錯,依然需要你手動補上下文,依然會在關鍵任務上忘記最重要的規則。
你以為問題在於模型不夠強。
於是你換更昂貴的模型、開啟最高推理強度、拉大 Context Window、購買更高級的訂閱方案。最後換來的,往往不是穩定可靠的工作成果,而是一張越來越難看的帳單。
模型確實更強,但它仍然不知道:
- 哪些資訊是這次任務真正需要的。
- 哪一份 SOP 才是最新、最可信的版本。
- 哪些規則只是背景知識,哪些是不可違反的限制。
- 上一次失敗後,到底應該修正什麼。
- 哪些經驗應該沉澱成流程,而不是只留在某段對話裡。
如果 AI 每次工作都要重新理解你、重新尋找資料、重新猜測流程,那它再強,也只是在昂貴地重複犯錯。
問題不在於你缺少更多 Prompt、更多 Memory,或更大的模型。
問題在於:你還沒有替 Agent 建立一套可以被準確取用、持續更新、版本可追蹤的工作架構。
而這正是 Skills 真正有價值的地方。
把 AI 想成一位能力很強、但非常健忘的員工
把 Hermes 或任何 AI Agent 想成一位你請過最能幹、但沒有長期記憶的員工。
他反應快、工具用得熟、可以讀文件、寫程式、查資料、跑指令,也能處理多步驟任務。但只要你沒有把工作規則整理好,他就只能根據眼前看到的資訊猜測。
有時候猜對,有時候猜錯。
你不會希望一位新員工每天上班時,都要重新問一次:
- 公司做什麼?
- 這個專案的目標是什麼?
- 資料庫在哪裡?
- 報表怎麼命名?
- 程式要怎麼執行?
- 發現資料異常時該停止、修正,還是繼續?
- 哪些規則是建議,哪些規則絕對不能違反?
但現在,多數人就是這樣在使用 AI。
你替它接好工具,例如 MCP、瀏覽器、自動化工具、資料庫、GitHub、雲端硬碟、Python 環境或交易資料 API;但真正決定工作品質的,不是工具裝了多少,而是它有沒有清楚的工作方法。
這就是 Skills 的角色。
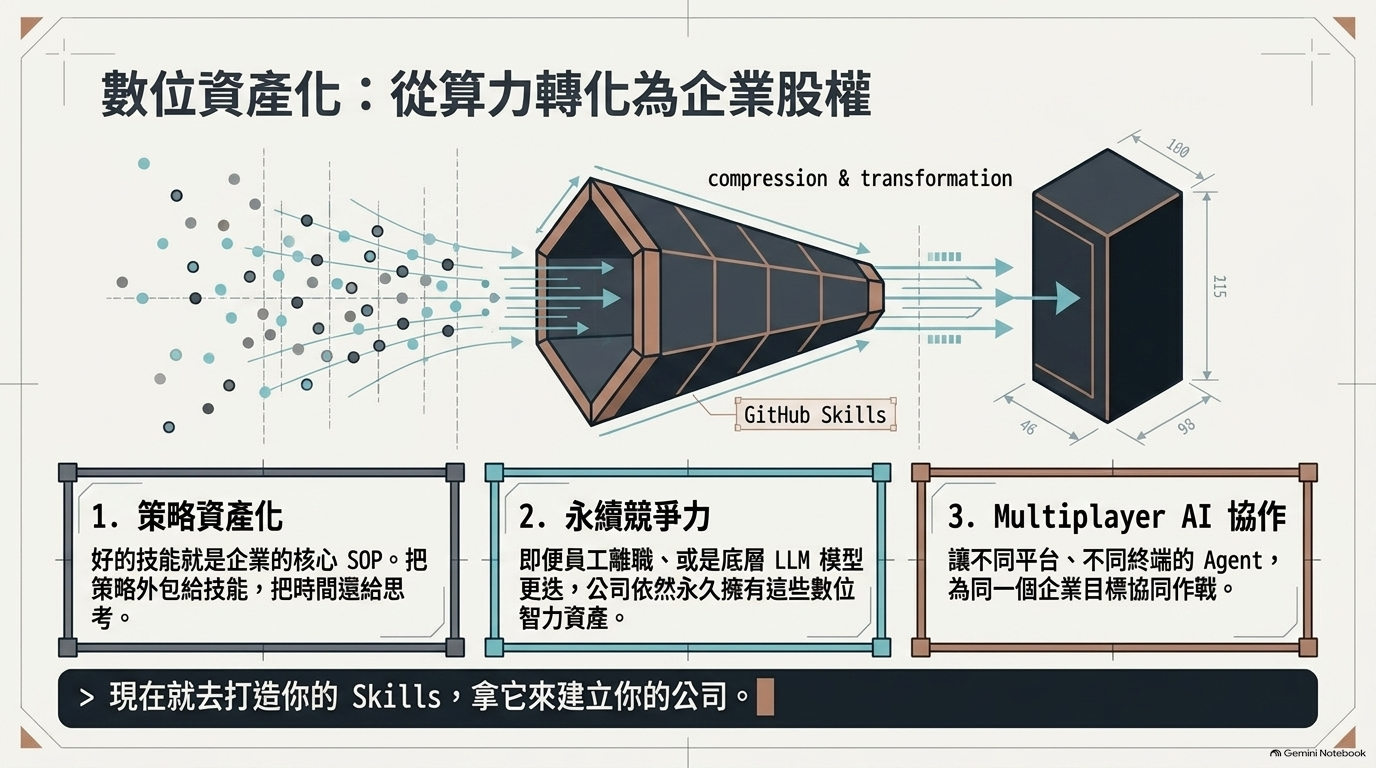
你可以把 Skills 想成這位員工身後的一整面 SOP 書櫃。
桌上放的是基本工作規則,例如安全原則、檔案命名、溝通方式、輸出標準與工具權限。書櫃裡則放著不同類型的專業流程,每一本都對應一項可重複執行的工作。
例如:
- 台股資料下載、清理與欄位驗證。
- 因子策略的研究、回測與避免過度擬合檢查。
- 選擇權策略的波動率、風險與情境分析。
- 每日市場資料更新、異常偵測與通知。
- GitHub 專案初始化、測試、提交與版本發布。
- PDF、Markdown、網頁資料的知識庫整理與索引。
- 研究報告的產出格式、圖表標準與結論檢查。
每個 Skill 都可以是一份 Markdown 文件。
檔案頂部的 name 和 description,就像印在書背上的標題與摘要。當 Agent 接到任務時,不需要把整個知識庫塞進 Context,也不需要重新讀完你所有歷史對話。
它只需要辨識任務,找到對應的 Skill,抽出必要的 SOP,然後依照規則完成工作。
這才是有效率的上下文管理。
不是把所有東西都塞給模型,而是讓模型在需要時,精準取用正確的資訊。
多數人仍停留在 Skills 的「Microsoft Word 時代」
現在大多數人管理 Prompt、SOP 與 AI 工作流程的方法,其實很像早期管理 Word 文件。
筆電裡有一堆 .docx、.txt、.md 和聊天紀錄;不同專案散落在不同資料夾;有些 Prompt 放在 Notion,有些放在 Obsidian,有些存在 Telegram、Slack、LINE 或 ChatGPT 對話裡。
時間一久,檔案名稱通常會變成這樣:
回測流程_final.md回測流程_final_v2.md回測流程_final_v2_修正版.md真的最後版本.md這個先不要刪.md
更常見的情況是:你曾經修正過一個重要問題,但只有當時那段對話知道答案。幾週後,你重新開始類似任務,Agent 又依照舊流程重做一次,甚至重複踩進同一個坑。
這不是 AI 不夠聰明。
這是因為你的工作知識沒有一個明確、可信、可追蹤的來源。
換句話說,你沒有建立 單一事實來源(Single Source of Truth)。
當沒有單一事實來源時,知識庫的規模越大,不一定越有用,反而可能越危險。因為你無法確定:
- 哪一份流程是目前有效版本。
- 哪些內容已經過期。
- 哪些規則只是特定情境下的例外。
- 哪次修正是經過驗證的,哪些只是臨時猜測。
- Agent 這次找到的資料,是否比另一份資料更可信。
這也是為什麼很多人的知識庫越做越大,AI 卻沒有越來越可靠。
文件量增加,不等於可用知識增加。
真正重要的不是「儲存更多」,而是「讓正確的資訊在正確的時候被取用」。
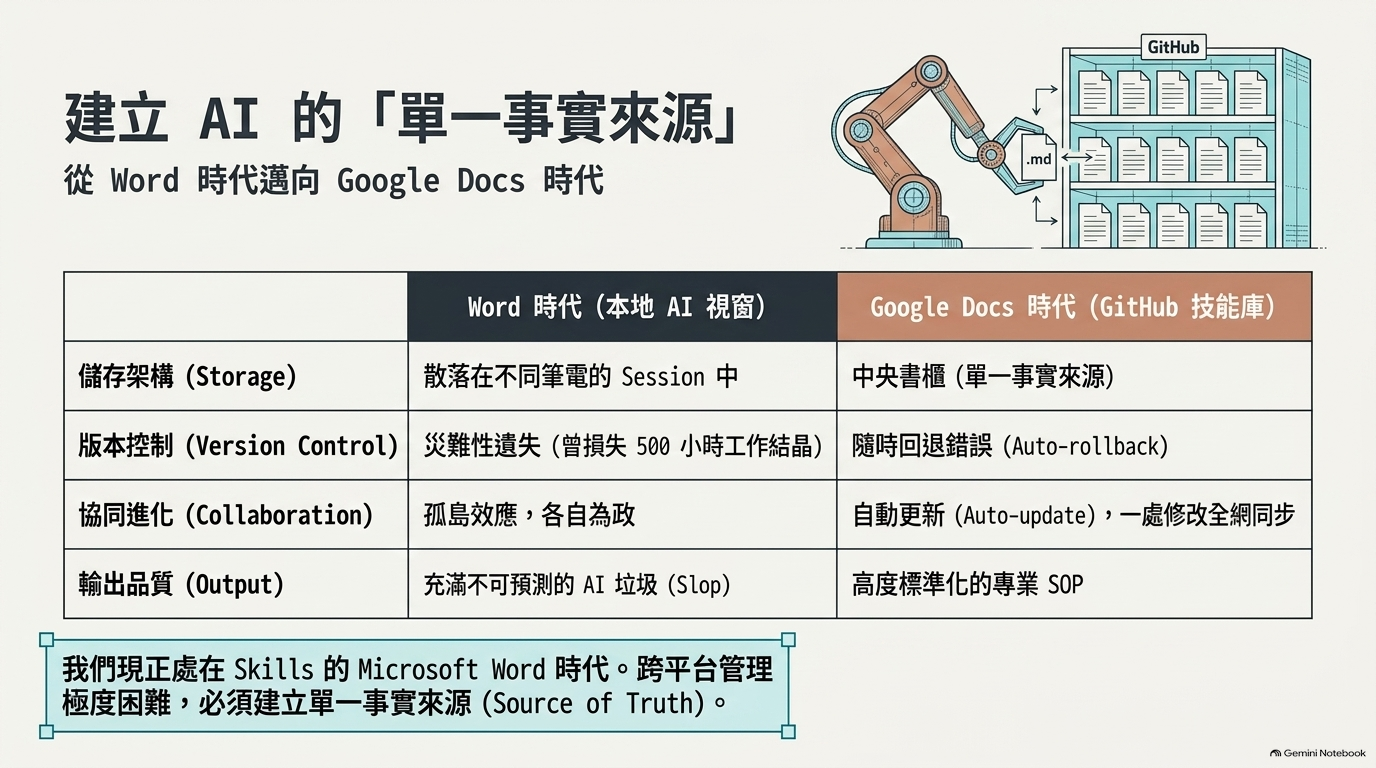
從 Microsoft Word 時代,走進 Google Docs 時代
我們需要的,不是一堆散落各處的提示詞,而是一套可以同步、版本化、協作與回退的 Skills 系統。
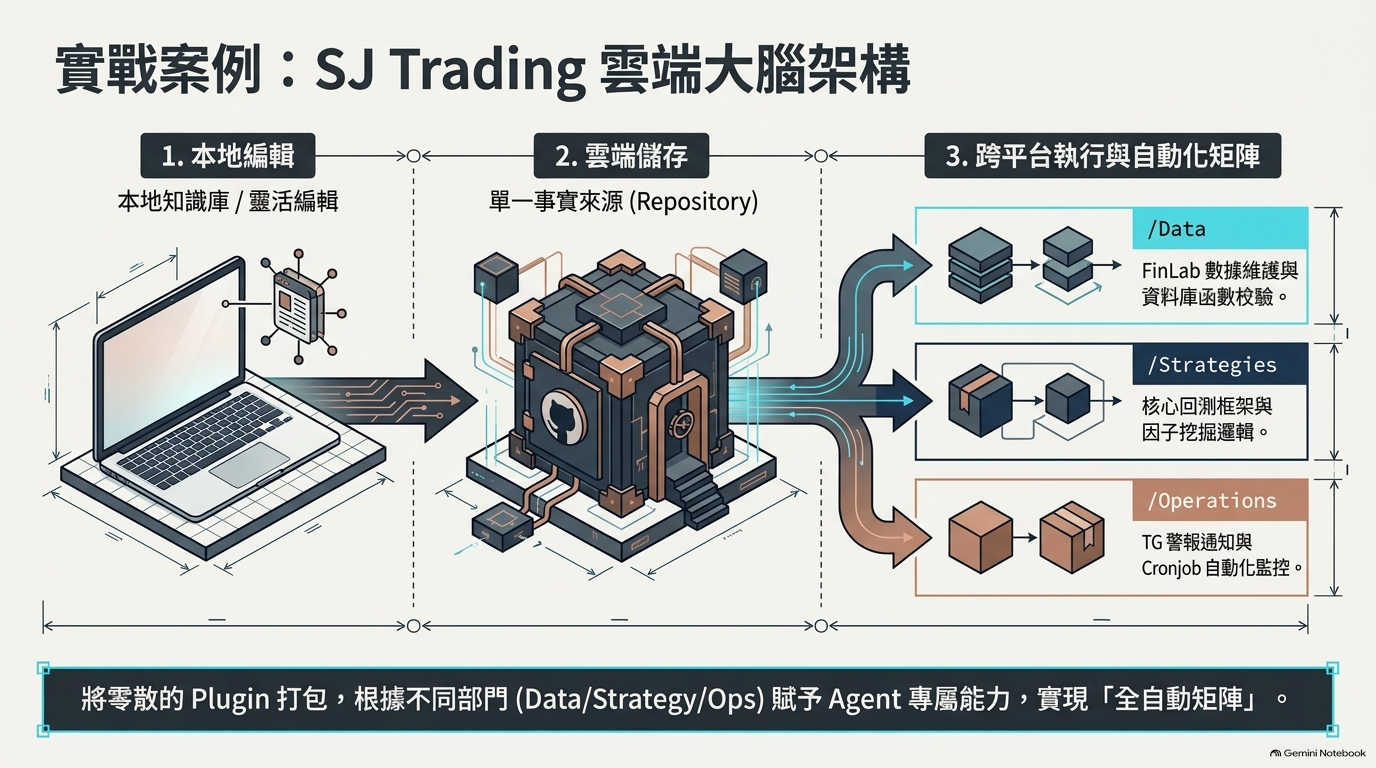
最實用的做法之一,就是把 Skills 放進 GitHub Repository,並以 Plugin、Skill Pack 或 SOP Library 的形式管理。
可以把這個架構簡單理解為:
| 元件 | 可以怎麼理解 | 實際作用 |
|---|---|---|
| GitHub Repository | 你的雲端技能庫 | 集中保存所有 Skills、SOP、範本與設定 |
| Git | 版本控制與時間機器 | 記錄誰改了什麼、為什麼改,也能隨時回退 |
| Plugin | 可安裝的能力模組 | 將特定工作流程封裝成可重複使用的技能組 |
| Marketplace | AI 工作流程的 App Store | 用來發現、安裝、分享或更新技能包 |
| Auto-Update | 跨裝置同步機制 | 讓不同電腦、VPS 或 Agent 使用相同版本規則 |
GitHub 對程式工作者來說,早已是日常工具;但對 AI Agent 使用者而言,它更像一顆能夠持續同步的雲端大腦。
假設你在 A 電腦優化了「台股策略回測 SOP」:
- 補上資料缺值檢查。
- 規定不能偷看未來資料。
- 新增交易成本與滑價假設。
- 明確要求輸出年化報酬、最大回撤、Sharpe Ratio、勝率與換手率。
- 增加一段過度擬合檢查流程。
如果這些規則只存在於某段對話,或只存於你的本機筆記,其他設備上的 Agent 不會知道。
但如果它們被寫進 GitHub 的 Skill Repository,並透過同步或 Auto-Update 機制部署,那麼:
- B 電腦上的 Hermes 會使用新版 SOP。
- 雲端 VPS 上跑排程的 Agent 也會遵循同一套規則。
- 未來的新專案可以直接沿用,不必重新解釋。
- 團隊成員或未來的你,都能看到改動歷史。
- 如果某次更新導致流程失效,還能直接比較版本差異,或回退到上一版。
這就是從「文件散落」走向「系統化技能管理」的差別。
你不再依賴記憶,也不再依賴某一段永遠找不回來的聊天紀錄。
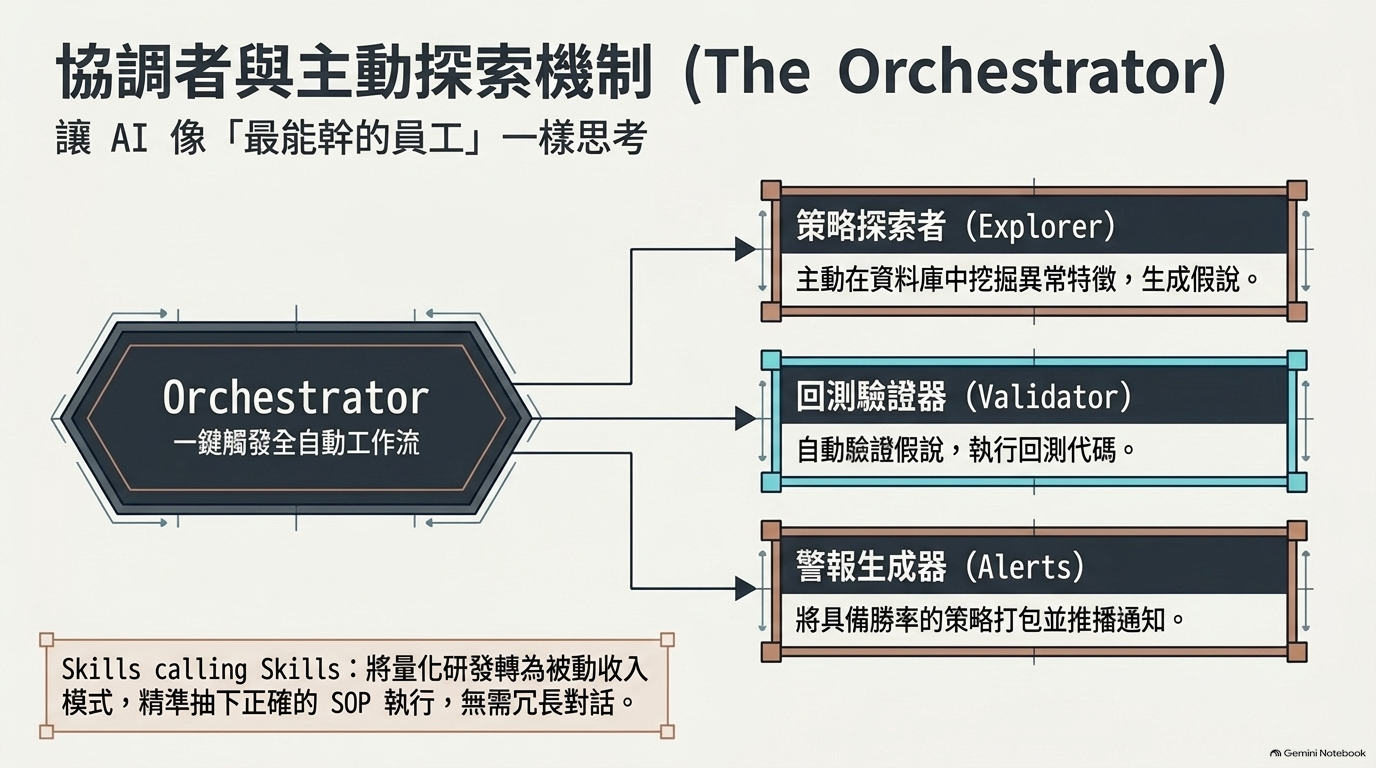
Skills 的重點:不是 Prompt,而是可執行的工作方法
一份好的 Skill,不應該只是長篇 Prompt。
它更像是一份為 Agent 寫的作業手冊:清楚定義任務目標、輸入資料、執行步驟、工具使用方式、品質標準、例外處理與交付格式。
以一個「量化策略回測」Skill 為例,它不應只寫:
幫我找出一個績效好的台股策略並回測。
這種指令太寬泛,模型一定需要大量來回溝通,也很容易自行補完你沒有同意的假設。
較成熟的 Skill,應該至少包含以下內容:
---
name: tw-stock-backtest
description: 用於台股策略研究、資料驗證、回測與績效報告產出。
---

# 任務目標
建立可重現的台股策略回測,避免未來函數與不合理假設。

# 執行原則
- 使用明確的資料期間與交易日曆。
- 禁止使用回測期間當下無法取得的資料。
- 必須納入交易成本、滑價與流動性限制。
- 所有計算過程須可重現。
- 若資料品質不足,先停止並回報,不得自行猜測補值。

# 必要輸出
- 策略邏輯與選股條件
- 樣本內與樣本外結果
- 年化報酬率、最大回撤、Sharpe Ratio、勝率、換手率
- 與大盤或基準指數比較
- 主要風險、失效情境與過度擬合檢查
- 可重現的程式與資料版本資訊

# 例外處理
- 發現缺值、欄位定義不一致或日期錯位時,停止回測。
- 發現結果異常優秀時,優先檢查未來函數、除權息、倖存者偏差與成交假設。
這份文件的價值不在於字數,而在於它替你保存了判斷標準。
下次你要做回測時,不必再記得所有細節。Agent 也不用靠猜測來決定要不要計入滑價、是否檢查未來函數、或該用什麼格式輸出結果。
你把經驗寫進了系統。
這才叫做把策略外包給 Skills。
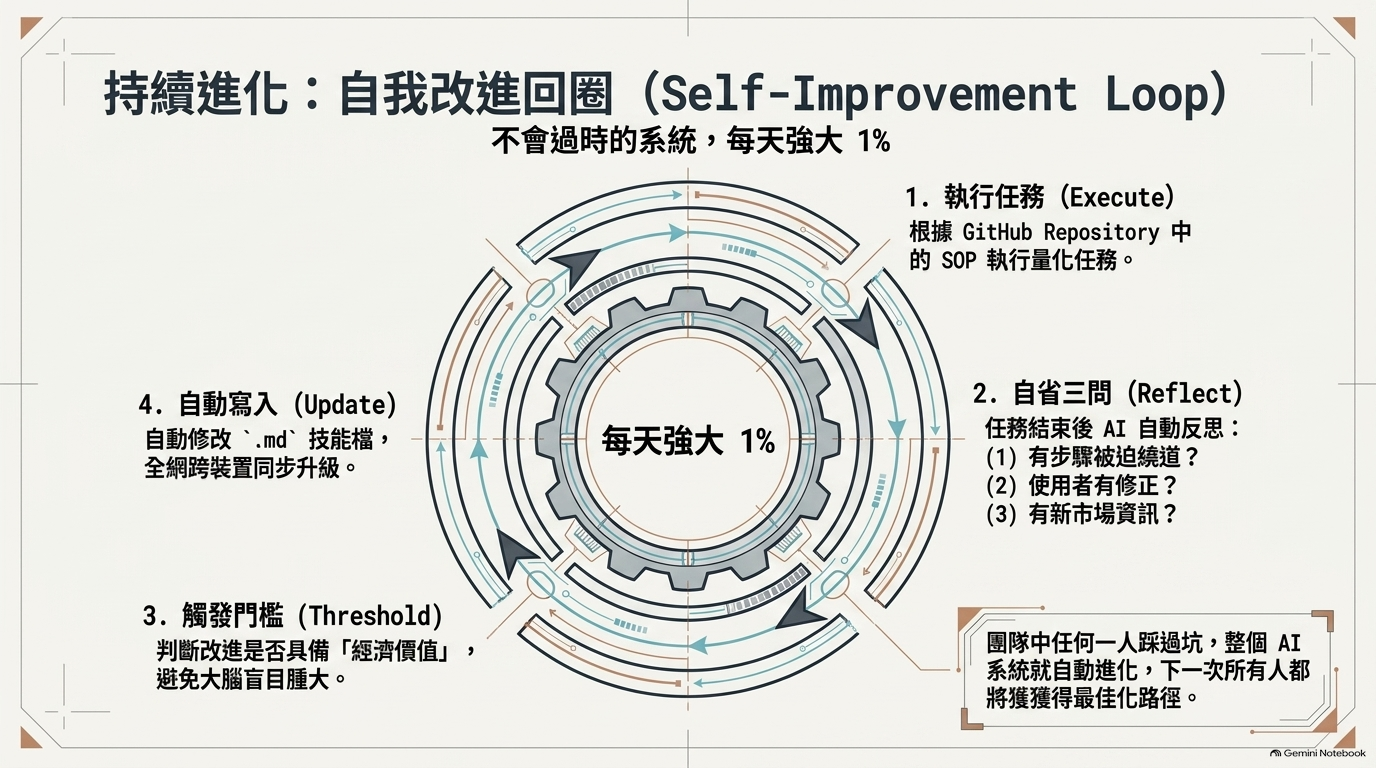
別讓 Agent 自己亂學:建立可控的自我改進回圈
「AI 自我進化」聽起來很吸引人,但如果沒有管理機制,它也可能變成最危險的部分。
一個 Agent 如果可以不受限制地修改 SOP、覆寫知識庫、更新 Memory,短期看起來很自主,長期卻很容易把臨時的錯誤判斷寫成正式規則。
它可能因為一次特殊案例,就改掉原本有效的流程;也可能把使用者隨口的一句話,誤當成永久偏好。更糟的是,錯誤一旦被寫回技能庫,之後所有任務都可能跟著被污染。
所以,真正可靠的自我改進,不是讓 AI 自己決定怎麼進化,而是讓它建立一套「發現問題、提出建議、等待核准、留下版本紀錄」的改善回圈。
你可以在每個 Skill 的底部加入這段規則:
## Self-Improvement Loop

每次任務結束後,請進行以下檢查:

1. 是否有任何步驟失敗、資訊不足,或需要替代方案才能完成?
2. 使用者是否修正、否決或補充了既有流程?
3. 是否發現新的資料來源、例外情境、品質檢查需求或風險?
4. 這些經驗是否值得寫回目前的 Skill,避免未來重複犯錯?

若建議更新,請輸出:

- 建議修改的檔案與段落
- 原本規則
- 建議的新規則
- 修改原因
- 可能受影響的任務
- 是否需要測試或人工驗證

未經使用者明確確認,不得直接修改正式 Skill、Memory 或 GitHub Repository。
這段設計的核心很簡單:
AI 可以發現問題,也可以提出改善方案;但正式知識的更新,必須可審核、可追蹤、可回退。
一個健康的循環應該是:
- Agent 執行任務。
- Agent 記錄失敗、例外、繞道方式與使用者修正。
- Agent 判斷這是否具有重複價值。
- Agent 提出具體的 Skill 更新建議。
- 使用者確認後,才寫回 GitHub。
- 新版 Skill 經過測試後,成為下一次任務的標準流程。
這樣,AI 的「學習」才不會只是把更多資料塞進 Memory,而是把真正有價值的經驗,整理成更可靠的工作方法。
Token 節省,不是少講話,而是少讀錯東西
很多人處理 Token 成本時,第一反應是縮短 Prompt、少開幾次對話、降低模型推理強度。
這些方法有幫助,但只處理了表面問題。
真正浪費 Token 的,通常不是你說得太多,而是模型讀了太多不該讀的東西,或在不完整的規則下重複做錯。
例如:
- 每次都把整份知識庫塞進 Context。
- 每次都從頭解釋專案背景。
- 讓模型反覆搜尋多個互相矛盾的版本。
- 因為規則不清楚,產生多輪確認與重工。
- 任務失敗後沒有把教訓沉澱成 SOP,下一次又重來。
- 使用最高階模型處理其實可由固定流程完成的工作。
成熟的 Skills 架構會把工作拆開:
| 任務類型 | 比較適合的做法 |
|---|---|
| 穩定、重複、規則明確的工作 | 使用固定 Skill、較便宜模型或自動化流程 |
| 需要查核、判斷與推理的工作 | 讀取相關 Skill,再使用較強模型處理 |
| 高風險或不可逆操作 | 加入明確檢查點與人工確認 |
| 新問題或探索型任務 | 允許較大的探索空間,結束後再評估是否固化為 Skill |
| 已被驗證的工作流程 | 直接依 SOP 執行,避免每次重新推理 |
這樣做不是限制 AI,而是把昂貴的推理能力留給真正需要思考的地方。
你不會叫資深研究員每天重新發明 Excel,也不該讓最昂貴的 AI 模型,每次都重新理解一套早已驗證過的工作流程。
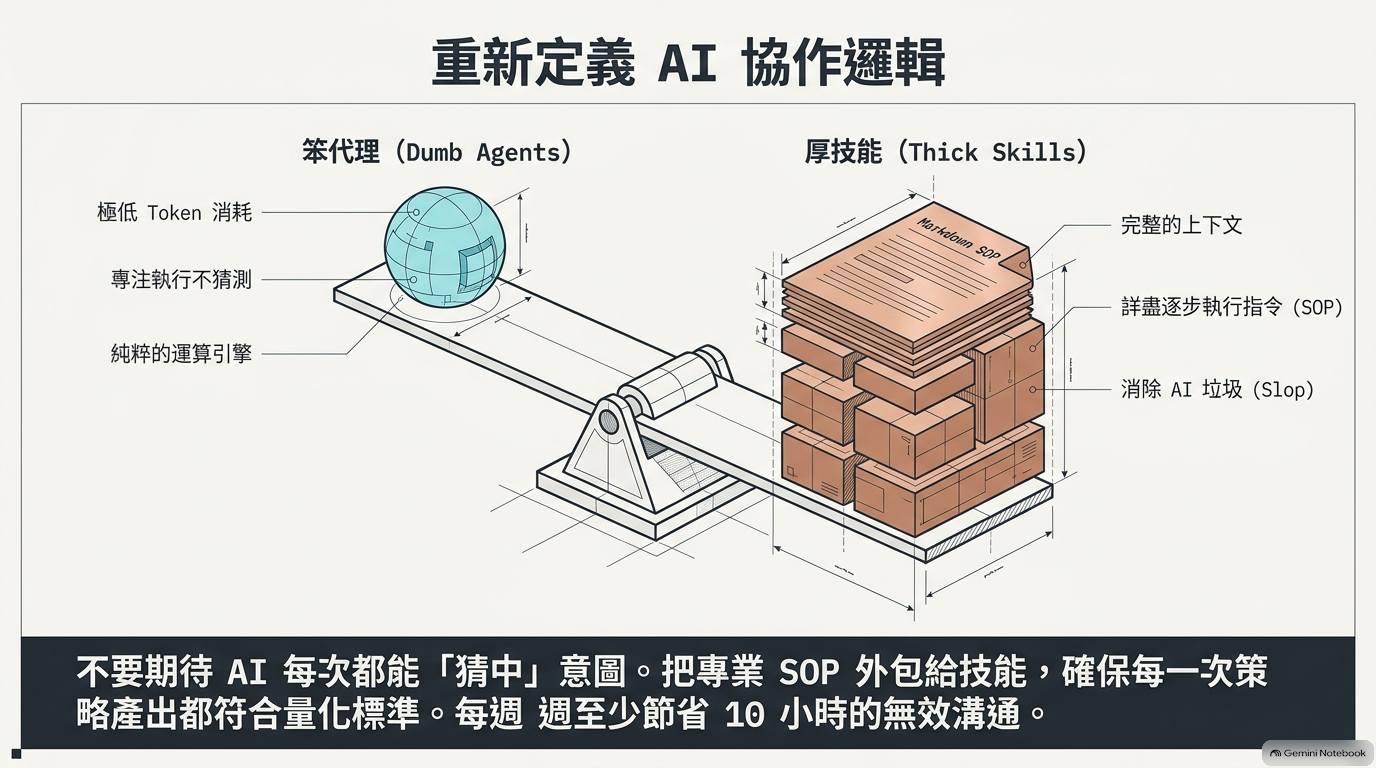
結論:笨代理,厚技能
不要試圖訓練一個完美的 Agent。
模型會更新,工具會更換,平台會改版,Memory 機制也可能不斷變動。把所有希望押在某一個模型「終於記得你」上面,通常不是長期解法。
更穩健的做法是:
- 保持 Agent 本身精簡。
- 把工具接好,但不要迷信工具數量。
- 把你的專業判斷、流程、檢查標準與例外情境,逐步寫進 Skills。
- 讓每個 Skill 都有清楚的版本、來源與維護方式。
- 讓 Agent 在需要時精準取用,而不是把所有資訊塞進 Context。
- 讓 AI 提出改善建議,但由你決定什麼可以成為正式規則。
- 用 GitHub 保留每一次重要變更,讓知識能同步,也能回退。
這就是「笨代理,厚技能」。
Agent 不需要假裝無所不知。它只需要有能力找到正確的 SOP、使用正確的工具、遵循正確的標準,並在出現新情況時,把問題明確地回報給你。
真正的不公平優勢,不是你用了最昂貴的模型,也不是你寫出了最長的 Prompt。
而是當別人還在每次新對話裡重新交代背景、重新搜尋筆記、重新修正相同錯誤時,你已經擁有一套會累積、會同步、可回溯、可審核,並能逐漸變得更可靠的技能系統。
你不是在做一堆 AI 對話。
你是在建立一座能持續複利的自動化能力工廠。
知識來源:本篇觀點與「笨代理,厚技能」框架,啟發自 AI with Remy(Remy Gasco)podcast。文中簡報圖(
Quant_Skill_Maxxing系列)為配套視覺化素材。